
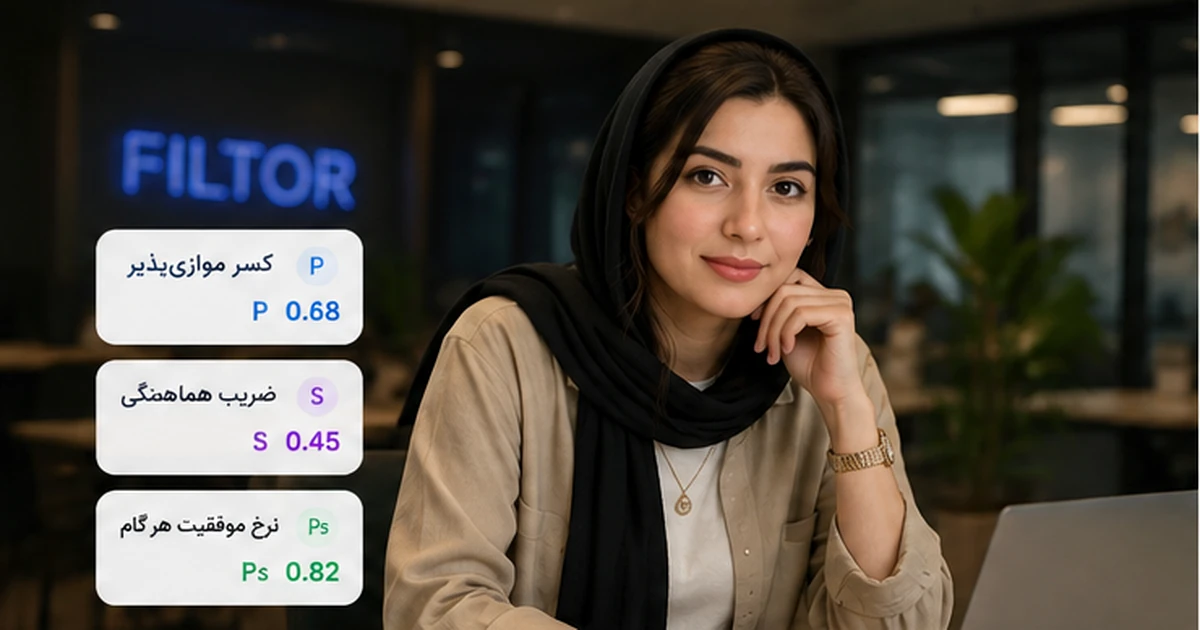
خلاصهی تصمیم
اگر یک جمله از این مقاله بخوانید، این باشد: تعداد ایجنتها یک انتخاب معماری نیست، یک نتیجه است. وقتی سه کمیت زیر را برای کار خودتان اندازه بگیرید، عدد درست خودش بیرون میآید — و در اکثر پروژههای واقعی کسبوکار، آن عدد یک است.
- عدد اول — کسر موازیپذیر. اگر ۷۰٪ کار قابل موازیسازی باشد، سقف شتاب شما ۳٫۳ برابر است، حتی با بینهایت ایجنت. این قانون امدال است و راه فراری از آن نیست.۱
- عدد دوم — ضریب هماهنگی. برخلاف امدال، افزودن ایجنت فقط بیاثر نمیشود؛ از یک نقطه به بعد عملکرد را پایین میآورد. قانون مقیاسپذیری جهانی، پس از برآورد پارامترهای واقعی سیستم، میتواند نقطهی اوج را مدل کند.۲
- عدد سوم — نرخ موفقیت هر گام. در زنجیرهای که موفقیت همهی گامها لازم است، قابلیت اطمینان میتواند ضربی افت کند. با فرض استقلال و موفقیت ۹۵٪ در هر گام، ده گام حدود ۶۰٪ موفق میشوند.
- واقعیت میدانی نگرانکنندهتر است. در τ-bench، GPT-4o در بخش خردهفروشی pass^1 برابر ۶۱٫۲٪ داشت، اما pass^8 آن به کمتر از ۲۵٪ رسید.۳
- نیروی مقابل واقعی است. بررسی ۱۸ مدل پیشرو نشان داد همه با افزایش طول ورودی افت میکنند. این «زوال زمینه» یکی از مهمترین دلایل فنی برای بررسی معماری چندایجنتی است.۴
- پاسخ عملی معمولاً معماری سوم است: یک ایجنت اصلی که تصمیم میگیرد و مینویسد، بهعلاوهی چند زیرایجنت فقطخواننده که موازی جستوجو میکنند.
تعریفهای پایه — ایجنت چیست، چهار معماری اصلی، پروتکلهای MCP و A2A — در راهنمای سیستم چندایجنتی آمده و اینجا تکرار نمیشود. این صفحه فقط یک کار میکند: به شما کمک میکند تصمیم بگیرید.
چرا این پرسش معمولاً بد پرسیده میشود
«چندایجنتی بهتر است یا تکایجنتی؟» مثل پرسیدن «چند نفر برای این پروژه استخدام کنم؟» بدون گفتن اینکه پروژه چیست. پاسخ به ساختار کار بستگی دارد، نه به ترجیح معماری. دو شرکت پیشرو با دادهی واقعی به دو نتیجهی متضاد رسیدهاند — چون دربارهی دو نوع کار حرف میزنند.
در طول ۲۰۲۵ و ۲۰۲۶ دو موضع صنعتی شکل گرفت که هر دو با شواهد پشتیبانی میشوند:
موضع «بشکن و موازی کن»
- معماری ارکستریتور-کارگر در ارزیابی داخلی پژوهشِ پهنا-محور Anthropic، ۹۰٫۲٪ بهتر از خط پایهی تکایجنتی همان شرکت عمل کرد.۵
- هر زیرایجنت پنجرهی زمینهی مستقل خودش را دارد؛ سیستم عملاً چند برابر «فضای فکر» میگیرد.
- اجرای موازی ۳ تا ۵ زیرایجنت، زمان را تا ۹۰٪ کم کرد.
- مصرف توکن بهتنهایی ۸۰٪ واریانس عملکرد را توضیح میدهد.
موضع «زمینه را نشکن»
- ایجنتهای موازیِ نویسنده ممکن است دربارهی سبک، لبههای مسئله و الگوی اجرا تصمیمهای ضمنی ناسازگار بگیرند.۶
- هرچه عاملها عملِ نوشتن بیشتری انجام دهند، انتقال زمینه و تصمیمهای قبلی مهمتر و هماهنگی پرهزینهتر میشود.
- الگوی محافظهکارانه: نوشتن نهایی تکرشتهای بماند و زیرایجنتها بیشتر نقش جستوجو، بررسی و مشاوره داشته باشند.
- بررسی میدانی ۷ فریمورک متنباز، نرخ شکست ۴۱ تا ۸۶٫۷٪ نشان داد.۷
نکته این است که این دو موضع دربارهی دو نوع کار متفاوت صحبت میکنند. Anthropic چندایجنتی را برای پژوهش پهنا-محور مناسب میداند، اما برای کارهای وابسته و زمینهمشترک محدودیت قائل است. Cognition نیز در جمعبندی بهروزتر خود میگوید الگوهای مفید معمولاً جایی هستند که چند عامل «هوش و بررسی» اضافه میکنند، ولی نوشتن نهایی تکرشتهای میماند.۵۶
اختلاف این دو موضع، اختلاف بر سر معماری نیست — اختلاف بر سر این است که کارِ نمونهی هرکدام چقدر موازیپذیر بوده. پس بیایید همان را اندازه بگیریم.
عدد اول: کسر موازیپذیر (قانون امدال)
قانون امدال میگوید شتابِ حاصل از موازیسازی، به بخشی که نمیتواند موازی شود محدود است. اگر ۳۰٪ کار ذاتاً ترتیبی باشد، حتی با بینهایت ایجنت بیش از ۳٫۳ برابر شتاب نمیگیرید. این سقف را هیچ مدل بهتری جابهجا نمیکند.
وقتی N به بینهایت میل کند: Smax = 1 / (1 − P)
حالا این را برای کارهای واقعی حساب کنیم. ستون آخر مهمترین ستون این مقاله است:
| نمونهی کار | کسر موازیپذیر تخمینی | شتاب با ۵ ایجنت | سقف مطلق شتاب |
|---|---|---|---|
| پایش همزمان ۵ کانال فروش | ~۹۰٪ | ۳٫۶× | ۱۰× |
| پژوهش بازار از چند منبع مستقل | ~۸۰٪ | ۲٫۸× | ۵× |
| تولید گزارش از دادهی چند سیستم | ~۷۰٪ | ۲٫۳× | ۳٫۳× |
| پاسخگویی به یک مشتری در ربات فروش | ~۳۰٪ | ۱٫۳× | ۱٫۴× |
| نوشتن یک ماژول کد یکپارچه | ~۲۰٪ | ۱٫۲× | ۱٫۲۵× |
دو ردیف آخر را نگاه کنید. برای یک ربات فروش که با یک مشتری گفتوگو میکند، حتی اگر بینهایت ایجنت بیاورید، بیش از ۴۰٪ سریعتر نمیشوید — چون کار ذاتاً ترتیبی است: باید سؤال را بفهمی، بعد موجودی را چک کنی، بعد قیمت بدهی، بعد سفارش بگیری. هر گام به خروجی گام قبل وابسته است.
کار را روی کاغذ به مراحل بشکنید. برای هر مرحله بپرسید: «آیا این مرحله برای شروع، به خروجی مرحلهی دیگری نیاز دارد؟» نسبت مراحلی که پاسخشان «نه» است، تخمین اولیهی P شماست. اگر زیر ۵۰٪ بود، بحث چندایجنتی را همینجا ببندید.
عدد دوم: ضریب هماهنگی و نقطهی برگشت
قانون امدال بدبینانه است اما هنوز خوشبین. در سیستمهای واقعی، ایجنتها باید با هم هماهنگ شوند و این هماهنگی خودش هزینه دارد — هزینهای که با مربع تعداد ایجنتها رشد میکند. نتیجه: بازده فقط اشباع نمیشود، بلکه از یک نقطه به بعد منفی میشود.
برای تخمین هزینهی هماهنگی میتوان از «قانون مقیاسپذیری جهانی» الهام گرفت؛ مدلی که در مهندسی عملکرد سیستمهای توزیعشده استفاده میشود.۲ این یک مدل تقریبی برای طراحی ایجنتهاست، نه قانون تجربیِ اثباتشده برای رفتار معنایی LLMها. پارامترهای آن باید از اندازهگیری سیستم خودتان برازش شوند و دو جریمه را مدل میکنند:
نقطهی بیشینه: Nmax = √( (1 − α) / β )
ترجمهی این دو پارامتر به زبان سیستمهای چندایجنتی:
- α (رقابت) — گلوگاههای مشترک: محدودیت نرخ API، ایجنت سرپرستی که باید همه را هماهنگ کند، یک پایگاهدادهی مشترک.
- β (همبستگی) — هزینهی این که هر ایجنت باید بداند بقیه چه کردهاند. این همان چیزی است که با مربع تعداد ایجنتها رشد میکند، چون تعداد جفتهای ارتباطی در یک گروه N نفره برابر N(N−1)/2 است.
برای دیدن رفتار فرمول، چند مقدار نمونه را حساب کنیم. این اعداد باید در پروژهی واقعی با اندازهگیری جایگزین شوند:
| سناریوی فرضی هماهنگی | α نمونه | β نمونه | نقطهی اوج محاسباتی |
|---|---|---|---|
| ایجنتها تقریباً مستقل، خروجیها جدا | ۰٫۱ | ۰٫۰۱ | ~۹ ایجنت |
| هماهنگی سبک، سرپرست نتایج را ترکیب میکند | ۰٫۱ | ۰٫۰۲ | ~۷ ایجنت |
| هماهنگی متوسط، زمینهی نسبی مشترک | ۰٫۲ | ۰٫۰۵ | ~۴ ایجنت |
| وابستگی بالا، همه باید همهچیز را بدانند | ۰٫۳ | ۰٫۱ | ~۳ ایجنت |
این جدول یک مثال محاسباتی است، نه اندازهگیری عمومیِ α و β برای همهی سیستمها. با این حال نشان میدهد چرا در سناریوهای دارای هماهنگی متوسط، نقطهی بهینه میتواند در محدودهی چند ایجنت قرار بگیرد؛ توصیهی عملی «۳ تا ۷ زیرایجنت» نیز با گزارشهای میدانی همراستاست، اما باید روی داده و زیرساخت خودتان اندازهگیری شود.۵ پژوهش مستقلی دربارهی پروتکل تصمیمگیری نیز نشان داد نوع هماهنگی مهم است: رأیگیری در وظایف استدلالی و اجماع در وظایف دانشی عملکرد بهتری داشتند. بنابراین هزینه و کیفیت هماهنگی را نمیتوان یک مقدار ثابت فرض کرد.۹
در شبکهی کاملاً متصل، تعداد جفتهای ارتباطی تقریباً درجهدوم رشد میکند؛ به همین دلیل هماهنگی باید اندازهگیری و محدود شود.
اگر تعداد ایجنتهایتان را زیاد کردید و نتیجه بدتر شد، این باگ نیست — رفتار پیشبینیشدهی سیستم است. از نقطهی بیشینه گذشتهاید.
عدد سوم: مالیات قابلیت اطمینان
در زنجیرهای که موفقیت تمام گامها برای نتیجهی نهایی لازم است، قابلیت اطمینان میتواند ضربی افت کند. اگر هر گام مستقل و با احتمال ۹۵٪ درست باشد، پنج گام حدود ۷۷٪ و ده گام حدود ۶۰٪ موفق میشوند. برای شاخههای موازی، تلاش مجدد و گامهای اختیاری باید مدل متناسبتری بهکار برد.
| نرخ موفقیت هر گام | ۳ گام | ۵ گام | ۱۰ گام |
|---|---|---|---|
| ۹۹٪ | ۹۷٫۰٪ | ۹۵٫۱٪ | ۹۰٫۴٪ |
| ۹۵٪ | ۸۵٫۷٪ | ۷۷٫۴٪ | ۵۹٫۹٪ |
| ۹۰٪ | ۷۲٫۹٪ | ۵۹٫۰٪ | ۳۴٫۹٪ |
ردیف وسط یک مثال محاسباتی است، نه برآورد عمومیِ همهی سامانهها. اگر ده گام اجباری و مستقل هرکدام ۹۵٪ موفق باشند، احتمال موفقیت کل حدود ۶۰٪ میشود؛ در عمل، همبستگی خطاها، تلاش مجدد، مسیرهای جایگزین و اعتبارسنجی میتوانند نتیجه را تغییر دهند.
و واقعیت میدانی از این هم بدتر است
محک τ-bench معیاری به نام pass^k معرفی کرد: احتمال اینکه یک ایجنت همان وظیفه را در k اجرای مستقل، هر بار درست انجام دهد. این دقیقاً چیزی است که یک کسبوکار به آن نیاز دارد — نه موفقیت گاهبهگاه، بلکه موفقیت قابل اتکا.۳
نتیجهگیری نویسندگان صریح بود: ایجنتها در برابر تصادفیبودن و اطلاعات ناقص شکنندهاند، و «توانایی حل قابلاتکا و مکرر همان وظیفه، با افزایش k بهشدت افت میکند».
عددی که در نمودارهای بازاریابی میبینید pass^1 است. برای فرایندهایی که باید یک وظیفه را بارها با ثبات انجام دهند، روند pass^k تصویر واقعبینانهتری از قابلیت اطمینان میدهد. پیش از افزودن ایجنت پنجم، بپرسید: آیا نرخ موفقیت گامهای فعلیام را اندازه گرفتهام، یا فقط چند بار تست دستی کردهام؟
نیروی مقابل: زوال زمینه
تا اینجا هر سه عدد به نفع تکایجنت بودند. اما یک نیروی واقعی در جهت مخالف وجود دارد: مدلها هرچه ورودی طولانیتر شود بدتر عمل میکنند. بررسی ۱۸ مدل پیشرو نشان داد این افت جهانی است و حتی روی وظایف عمداً ساده هم دیده میشود.
پژوهش «زوال زمینه» (Context Rot) روی ۱۸ مدل شاخص انجام شد و یافتهی مرکزیاش این بود: مدلها از پنجرهی زمینهی خود بهطور یکنواخت استفاده نمیکنند؛ عملکردشان با افزایش طول ورودی بهطور فزایندهای غیرقابلاتکا میشود.۴
چند یافتهی مشخص که مستقیماً به تصمیم معماری ربط دارند:
- حتی یک عامل حواسپرتی کافی است. افزودن یک متن نامرتبط اما شبیه، دقت را پایین آورد — و شدت این اثر بین عوامل مختلف یکسان نبود.
- شباهت معنایی مهم است. وقتی شباهت بین پرسش و پاسخ کم بود، افت با افزایش طول زمینه تندتر میشد.
- حتی کپیکردن ساده هم افت میکند. در وظیفهی بازتولید متن (۲۵ تا ۱۰٬۰۰۰ کلمه) دقت بهطور سیستماتیک پایین آمد و مدلها در طولهای زیاد کمتولید کردند.
- یافتهی خلافشهود. مدلها روی انبار متنی نامنسجم و تصادفی بهتر عمل کردند تا انبار منطقی و منسجم.
این یافتهها یکی از مهمترین استدلالهای فنی به نفع چندایجنتی را میسازند: اگر هر زیرایجنت پنجرهی زمینهی کوچک و تمیز خودش را داشته باشد، هیچکدام به ناحیهی زوال نمیرسند. این همان سازوکاری است که Anthropic برای توضیح بهبود ۹۰٫۲٪ در ارزیابی داخلیِ پژوهش پهنا-محور خود مطرح میکند — زیرایجنتها بهعنوان فیلترهای هوشمند عمل میکنند و فقط عصاره را برمیگردانند.۵
سؤال «آیا زمینهی من از پنجره بیرون میزند؟» غلط است. سؤال درست این است: «آیا زمینهی من وارد ناحیهای شده که کیفیت افت میکند؟» — و این ناحیه بسیار زودتر از سقف اسمی پنجره شروع میشود. مدیریت این ناحیه موضوع مهندسی زمینه است.
آیا پنجرهی زمینهی بزرگتر مسئله را حل میکند؟
خیر — و این رایجترین اشتباه در برنامهریزی معماری است. بزرگتر شدن پنجرهی اسمی، ناحیهی افت کیفیت را حذف نمیکند، فقط جابهجایش میکند. پژوهش زوال زمینه نشان داد افت روی مدلهایی با پنجرههای بسیار بزرگ هم دیده میشود.
استدلال «صبر میکنیم پنجرهها بزرگتر شوند، بعد همهچیز را در یک ایجنت میریزیم» دو خطا دارد:
- خطای کیفی. ظرفیت اسمی با ظرفیت مؤثر یکی نیست. مدل ممکن است ۱ میلیون توکن را بپذیرد ولی کیفیت پاسخش از دهها هزار توکن به بعد افت کند.
- خطای اقتصادی. هزینهی ورودی خطی با طول زمینه رشد میکند. زمینهی بزرگ در هر فراخوان تکرار میشود، پس یک تصمیم معماری «ارزان» به یک هزینهی جاری تبدیل میشود.
به همین دلیل، فشردهسازی زمینه — خلاصهکردن تصمیمها و رویدادهای کلیدی بهجای حمل کل تاریخچه — معمولاً پیش از چندایجنتی باید امتحان شود.۶ این ارزانتر است، انسجام را حفظ میکند، و هیچکدام از سه جریمهی بخشهای قبل را نمیآورد.
معماری سوم: تکایجنت با زیرایجنتهای فقطخواننده
پاسخ عملی برای اکثر پروژهها نه تکایجنت خالص است نه چندایجنتی کامل: یک ایجنت اصلی که تمام تصمیمها را میگیرد و تمام خروجی را مینویسد، بهعلاوهی چند زیرایجنت که فقط میخوانند و یافتهی فشرده برمیگردانند. این ساختار سود موازیسازی را میگیرد بدون آنکه جریمهی هماهنگی را بپردازد.
منطقش مستقیماً از سه بخش قبل بیرون میآید:
| جریمه | چندایجنتی کامل | تکایجنت + زیرایجنت فقطخواننده |
|---|---|---|
| سقف امدال | محدود به کسر موازیپذیر | همان، ولی روی بخش جستوجو که واقعاً موازیپذیر است |
| ضریب β (همبستگی) | بالا — همه باید همه را بدانند | پایینتر — زیرایجنتها مستقیماً با هم هماهنگ نمیشوند |
| مالیات اطمینان | ضرب روی همهی گامها | فقط روی مسیر اصلی؛ یافتهی زیرایجنت پیش از سنتز قابل اعتبارسنجی است |
| زوال زمینه | حل میشود | حل میشود |
| تناقض خروجی | ریسک بالا | کمتر — فقط یک ایجنت خروجی نهایی را مینویسد |
قاعدهی طلایی که از این تحلیل بیرون میآید و در کل این خوشه تکرار میشود:
خواندن را موازی کن؛ نوشتن نهایی را متمرکز نگه دار.
یک نکتهی معماری که اغلب فراموش میشود: اگر زیرایجنتهای شما باید از مرز سازمان بیرون بروند و با ایجنت شرکت دیگری حرف بزنند، پروتکل استانداردی برای همین وجود دارد و در ۲۰۲۶ به بلوغ رسیده.۱۲ در این حالت ضریب همبستگی شامل تأخیر شبکه و احراز هویت هم میشود.
وقتی زیرایجنتها فقط اطلاعات جمع میکنند، تناقض ضمنی معنا ندارد — دو گزارش متفاوت از دو منبع، تناقض نیست، داده است. تناقض وقتی ساخته میشود که دو ایجنت هر کدام تکهای از یک خروجی واحد را بنویسند و فرضهای ناسازگار بگیرند.۶
← چهار معماری اصلی چندایجنتی ترتیبی، ارکستریتور-کارگر، سلسلهمراتبی و شبکهای — با معیار انتخابجدول تصمیم کامل
این جدول سه عدد بخشهای قبل را به یک توصیهی مشخص تبدیل میکند. ستون آخر را بخوانید و اگر بیش از یک ردیف به وضعیت شما میخورد، محافظهکارانهترین توصیه را انتخاب کنید.
| ویژگی کار شما | کسر موازیپذیر | ریسک هماهنگی | معماری پیشنهادی |
|---|---|---|---|
| یک گفتوگوی خطی با کاربر | پایین | — | تکایجنت |
| خروجی باید یک متن یا کد یکپارچه باشد | پایین | بالا | تکایجنت + فشردهسازی زمینه |
| چند مرحلهی وابسته با ابزارهای مختلف | پایین | متوسط | تکایجنت با ابزارهای متعدد۱۳ |
| جمعآوری اطلاعات از چند منبع مستقل | بالا | پایین | تکایجنت + زیرایجنت فقطخواننده |
| پژوهش پهنا-محور با حجم زیاد داده | بالا | پایین | ارکستریتور-کارگر (۳ تا ۷ کارگر) |
| پایش همزمان چند کانال مستقل | بسیار بالا | پایین | چندایجنتی موازی |
| ارزیابی کیفیت خروجی از چند بُعد | بالا | پایین | چندایجنتی — الگوی داوری |
| وظیفهای که مدل روی آن ضعیف است | — | — | تکایجنت + بازبینی انسانی |
اگر مدل روی وظیفهای ضعیف عمل میکند، افزودن ایجنت خطا را تقویت میکند نه فیلتر. دلیل ریاضیاش در بخش تناقض کندورسه مقالهی مناظره توضیح داده شده.
هزینه: سه لایهای که فقط یکیاش دیده میشود
مقایسهی هزینه معمولاً فقط روی توکن انجام میشود، در حالی که دو لایهی گرانتر هم وجود دارد: تأخیر، و هزینهی نگهداری و اشکالزدایی. لایهی سوم معمولاً در سال دوم پروژه از هر دو لایهی دیگر گرانتر درمیآید.
| لایه | تکایجنت | چندایجنتی | یادداشت |
|---|---|---|---|
| توکن | مبنا | حدود ۱۵ برابر یک مکالمهی ساده | هر زیرایجنت دستور سیستمی و تعریف ابزارها را از نو میگیرد۵ |
| تأخیر | مبنا | موازیسازی کم میکند، هماهنگی برمیگرداند | سود خالص فقط وقتی که β پایین باشد |
| نگهداری | مبنا | بهمراتب بالاتر | خطای راند سوم ایجنت دوم، در لاگ شبیه یک پاسخ معقول است |
نکتهی مهم دربارهی لایهی اول: بررسی مستقلی روی نُه محک نشان داد افزایش بودجهی محاسباتی لزوماً به دقت بیشتر ترجمه نمیشود — یعنی توکن بیشتر، بهخودیخود خرید کیفیت نیست.۱۰
لایهی سوم را نمیشود با معیار ساده اندازه گرفت، اما یک شاخص جانشین خوب دارد: زمان میانگین تشخیص علت یک خروجی اشتباه. اگر در سیستم تکایجنتی ده دقیقه طول میکشد و در نسخهی چندایجنتی دو ساعت، این تفاوت را در هزینهی ماهانهی تیم ضرب کنید.
تصویر کلان بازار هم همین را تأیید میکند: پیشبینی میشود تا پایان ۲۰۲۶ حدود ۴۰٪ اپلیکیشنهای سازمانی ایجنت وظیفهمحور داشته باشند، اما تا ۲۰۲۷ حدود ۴۰٪ پروژههای ایجنتیک لغو شوند — با سه دلیل نامبرده: هزینهی افسارگسیخته، بازگشت سرمایهی نامشخص، و ضعف حاکمیت.۱۱
چکلیست نُه پرسشی پیش از تصمیم
پیش از نوشتن یک خط کد معماری، این نُه پرسش را روی کاغذ پاسخ دهید. اگر به سه پرسش اول نتوانستید پاسخ عددی بدهید، هنوز آمادهی تصمیمگیری نیستید — و پاسخ پیشفرض تکایجنت است.
سه پرسش اول عددیاند. اگر برای هر سه عدد ندارید، تصمیم معماریتان یک حدس است — و حدس گرانترین بخش پروژههای ایجنتیک است.
پنج سناریوی واقعی و پاسخشان
این پنج سناریو از جنس درخواستهای واقعی کسبوکارهای ایرانیاند. در سه مورد پاسخ تکایجنت است، در یکی معماری ترکیبی، و فقط در یکی چندایجنتی کامل توجیه دارد.
فروشگاه اینترنتی — ربات فروش روی بله سناریو ۱
ربات باید محصول را پیدا کند، موجودی را چک کند، قیمت بدهد، سفارش ثبت کند و لینک پرداخت بفرستد.
← تکایجنت با ابزارهای متعدد. کسر موازیپذیر تقریباً صفر است چون هر گام به خروجی گام قبل وابسته است. چندایجنتی اینجا فقط هزینه و نقطهی شکست اضافه میکند. جزئیات پیادهسازی ربات بلهآژانس تبلیغاتی — پایش برند در چند شبکه سناریو ۲
باید همزمان چند شبکهی اجتماعی و چند سایت خبری را برای اشاره به نام برند رصد کند و گزارش روزانه بدهد.
← چندایجنتی موازی. کانالها کاملاً مستقلاند، ضریب هماهنگی نزدیک صفر است، و خروجی هر ایجنت یک «یافته» است نه تکهای از یک متن واحد. این نمونهی درسیِ موازیسازی است.شرکت خدماتی — تولید پیشنهاد قیمت اختصاصی سناریو ۳
باید نیاز مشتری را بفهمد، سوابق مشابه را از آرشیو دربیاورد، قیمتهای رقبا را ببیند، و یک پیشنهاد یکپارچه بنویسد.
← معماری ترکیبی. سه کار اول موازیپذیر و فقطخواندنیاند؛ کار چهارم باید حتماً توسط یک ایجنت واحد انجام شود تا لحن و منطق قیمتگذاری یکدست بماند.کلینیک — ربات نوبتدهی و پاسخ به پرسشهای رایج سناریو ۴
باید به پرسشهای تکراری پاسخ دهد، تقویم را ببیند، نوبت رزرو کند و یادآوری بفرستد.
← تکایجنت. نرخ موفقیت هر گام اینجا حیاتی است چون خطا مستقیماً به تجربهی بیمار میرسد. افزودن ایجنت، مالیات اطمینان را بالا میبرد بدون هیچ سود موازیسازی.تولیدکننده — تحلیل بازار برای ورود به یک محصول تازه سناریو ۵
باید دهها منبع را بخواند، قیمتها و رقبا را دربیاورد، و یک گزارش تحلیلی تولید کند.
← ارکستریتور-کارگر با ۳ تا ۵ کارگر فقطخواننده، و یک ایجنت واحد برای نوشتن گزارش. این شبیه همان الگوی ارزیابی داخلی Anthropic است که بهبود ۹۰٫۲٪ گزارش کرد — ولی توجه کنید سنتز نهایی هنوز تکایجنتی است.مسیر مهاجرت: از یک به چند، بدون فاجعه
اگر بعد از همهی این تحلیل به چندایجنتی رسیدید، یکباره نروید. پنج پله وجود دارد و در هر پله باید عدد بگیرید. اکثر تیمها متوجه میشوند در پلهی دوم یا سوم مسئله حل شده و ادامه لازم نیست.
- خط پایهی تکایجنتی + پرامپت قوییک ایجنت با ابزارهای درست و پرامپتی که مثال دارد. پژوهش نشان داده ایجنت تکی با پرامپت قوی اغلب به همان نتیجهی معماریهای پیچیده میرسد.۸ اینجا مجموعهی ارزیابیتان را بسازید — بدون آن، بقیهی پلهها معنا ندارند.
- فشردهسازی زمینهاگر به ناحیهی زوال زمینه خوردید، پیش از شکستن به چند ایجنت، تاریخچه را خلاصه کنید. ارزانترین راهحل ممکن، و انسجام را حفظ میکند.
- یک زیرایجنت فقطخوانندهسنگینترین کار جستوجو را به یک زیرایجنت بسپارید که فقط یافتهی فشرده برمیگرداند. β هنوز صفر است چون فقط یک زیرایجنت دارید.
- چند زیرایجنت موازی فقطخوانندهحالا β بالا میرود ولی هنوز پایین است، چون زیرایجنتها با هم حرف نمیزنند. سقف عملی: ۳ تا ۷، طبق محاسبهی بخش ۰۴.
- چندایجنتی کامل با نوشتن توزیعشدهفقط اگر پلهی چهارم واقعاً کافی نبود. اینجا باید ردِ کامل تصمیمها بین ایجنتها جریان داشته باشد و لایهی تأیید مستقل ضروری است.۷
در هر پله، عدد مجموعهی ارزیابی را ثبت کنید. اگر پلهی بعد بهبود معناداری نداد، همانجا بمانید. سیستمی که در پلهی دوم متوقف شده و کار میکند، از سیستمی که به پلهی پنجم رسیده و هفتهای دو بار خروجی متناقض میدهد ارزشمندتر است.
هفت اشتباه در انتخاب معماری
تصمیمگیری بدون خط پایه
معماری چندایجنتی را میسازید بدون آنکه بدانید نسخهی تکایجنتی چه عددی میگرفت.
درست: خط پایه بسازید، مجموعهی ارزیابی درست کنید، بعد تصمیم بگیرید.اشتباه گرفتن «کند» با «به سقف زمینه خورده»
سیستم کند است، پس فرض میکنید باید موازی شود. در حالی که شاید فقط ابزارهایتان کند باشند.
درست: اول منشأ تأخیر را اندازه بگیرید. موازیسازی برای تأخیر ابزار جواب نمیدهد.موازی کردن نوشتن
چند ایجنت هر کدام بخشی از یک گزارش یا یک ماژول کد را مینویسند. خروجی قابل ترکیب نیست.
درست: خواندن را موازی کنید، نوشتن را به یک ایجنت بسپارید.افزودن ایجنت برای بهبود کیفیت
نتیجه بد است، پس ایجنت اضافه میکنید. اگر مدل روی این وظیفه ضعیف است، این کار خطا را تقویت میکند.
درست: اول کیفیت یک ایجنت را بالا ببرید — پرامپت، ابزار، داده.نادیده گرفتن مالیات اطمینان
هر گام زنجیرهایِ اجباری یک عامل دیگر به حاصلضرب قابلیت اطمینان اضافه میکند، ولی در برنامهریزی حساب نشده.
درست: pN را قبل از افزودن هر ایجنت حساب کنید و ببینید نتیجه هنوز قابل قبول است یا نه.اعتماد به عدد pass^1
روی نرخ موفقیت یک اجرا برنامهریزی میکنید، در حالی که کاربر واقعی همان وظیفه را دهها بار تکرار میکند.
درست: هر وظیفه را چند بار اجرا کنید و نرخ موفقیت مکرر را گزارش دهید.انتخاب معماری بر اساس فریمورک
ابزاری را انتخاب کردهاید که چندایجنتی را آسان میکند، پس چندایجنتی میسازید.
درست: ساختار کار معماری را تعیین میکند، نه امکانات ابزار. فریمورک، معماری بد را نجات نمیدهد.۷جمعبندی
پیشفرض درست تکایجنت است، و بار اثبات بر دوش چندایجنتی. سه عدد این مقاله — کسر موازیپذیر، ضریب هماهنگی، و نرخ موفقیت هر گام — بار اثبات را از بحث سلیقهای به محاسبه تبدیل میکنند. یکی از مهمترین استدلالهای فنی به نفع چندایجنتی، زوال زمینه است؛ و پاسخ عملیِ آن معمولاً معماری ترکیبی است نه چندایجنتی کامل.
| اگر... | معماری |
|---|---|
| کسر موازیپذیر زیر ۵۰٪ است | تکایجنت — بدون بحث |
| خروجی باید یکپارچه باشد | تکایجنت، حتی اگر موازیپذیر باشد |
| به ناحیهی زوال زمینه خوردهاید | اول فشردهسازی، بعد زیرایجنت فقطخواننده |
| کار جستوجوی گسترده و مستقل است | ارکستریتور-کارگر، ۳ تا ۷ کارگر |
| نرخ موفقیت هر گام زیر ۹۰٪ است | تکایجنت + بازبینی؛ اول کیفیت را درست کنید |
| نمیتوانید سه عدد اول را بدهید | تکایجنت — هنوز آمادهی تصمیم نیستید |
تعداد ایجنتها یک انتخاب نیست؛ نتیجهی سه عددی است که باید اندازه بگیرید.
نمیدانید کدام معماری برای کسبوکار شما درست است؟
در یک جلسهی مشاورهی رایگان، کار شما را به مراحلش میشکنیم و کسر موازیپذیرش را تخمین میزنیم. اگر پاسخ «یک ایجنت ساده کافی است» باشد، همین را میگوییم — و معمولاً همین است.
ادامهی این خوشه
و اگر تازه وارد این حوزه شدهاید، ترتیب پیشنهادی: مهندسی زمینه ← مهندسی حلقه ← راهنمای چندایجنتی ← همین صفحه. برای پیادهسازی عملی هم خدمات اتوماسیون و نمونه کارها را ببینید.
ادامهی مطالعه بر اساس مسئلهی شما
برای جلوگیری از مطالعهی پراکنده، مسیر بعدی را براساس وضعیت پروژه انتخاب کنید.
پرسشهای پرتکرار
خیر. برتری چندایجنتی فقط وقتی ظاهر میشود که کسر موازیپذیر کار بالا باشد و ایجنتها نیاز کمی به هماهنگی داشته باشند. در کارهایی که خروجی باید یکپارچه باشد یا مراحل به هم وابستهاند، تکایجنت هم سریعتر است هم ارزانتر هم قابل اتکاتر.
کار را به مراحل بشکنید و برای هر مرحله بپرسید آیا برای شروع به خروجی مرحلهی دیگری نیاز دارد یا نه. نسبت مراحل مستقل، تخمین اولیهی شماست. طبق قانون امدال، اگر ۷۰٪ کار موازیپذیر باشد سقف شتاب شما ۳٫۳ برابر است حتی با بینهایت ایجنت.
عدد عمومی و ثابتی وجود ندارد. در بسیاری از پیادهسازیها ۳ تا ۷ نقطهی شروع آزمایشی است، اما عدد بهینه به کسر موازیپذیر، منابع مشترک و هزینهی هماهنگی بستگی دارد و باید با ارزیابی روی پروژهی واقعی تعیین شود.
در زنجیرهای که موفقیت همهی گامها لازم است، احتمال موفقیت کل میتواند حاصلضرب نرخ موفقیت گامها باشد. با فرض استقلال و موفقیت ۹۵ درصد در هر گام، پنج گام حدود ۷۷ درصد و ده گام حدود ۶۰ درصد موفق میشوند.
pass^k احتمال حل موفق همان وظیفه در k اجرای مستقل است. در τ-bench، GPT-4o در بخش خردهفروشی pass^1 برابر ۶۱٫۲ درصد داشت، اما pass^8 آن کمتر از ۲۵ درصد بود. برای فرایندهای پرتکرار، روند pass^k معیار مناسبتری برای سنجش ثبات است.
خیر. بررسی ۱۸ مدل پیشرو نشان داد عملکرد با افزایش طول ورودی افت میکند، حتی روی وظایف عمداً ساده. ظرفیت اسمی با ظرفیت مؤثر یکی نیست و هزینهی ورودی خطی با طول زمینه رشد میکند.
یک ایجنت اصلی تصمیمها را میگیرد و خروجی نهایی را مینویسد، در حالی که زیرایجنتها فقط اطلاعات جمع میکنند و یافتهی فشرده برمیگردانند. این ساختار هزینهی هماهنگی و ریسک تناقض را کاهش میدهد، اما همچنان به اعتبارسنجی یافتهها نیاز دارد.
تقریباً همیشه تکایجنت با ابزارهای متعدد. یک گفتوگوی فروش ذاتاً ترتیبی است، پس کسر موازیپذیر نزدیک صفر است و چندایجنتی فقط هزینه و نقطهی شکست اضافه میکند.
پرهزینهترین حالت، ساختن چندایجنتی برای کاری است که موازیپذیر نیست: هم چند برابر توکن میدهید، هم قابلیت اطمینان پایین میآید، هم اشکالزدایی چند برابر سخت میشود. بررسی میدانی ۷ فریمورک متنباز نرخ شکست ۴۱ تا ۸۶٫۷ درصدی نشان داد.
واژهنامه
- کسر موازیپذیرParallelizable Fraction
- نسبتی از کار که میتواند همزمان انجام شود؛ ورودی اصلی قانون امدال.
- قانون امدالAmdahl's Law
- سقف شتاب حاصل از موازیسازی، به بخش ترتیبیِ کار محدود است.
- قانون مقیاسپذیری جهانیUniversal Scalability Law
- مدلی که علاوه بر رقابت بر سر منابع، جریمهی درجهدوم همبستگی را هم حساب میکند و نقطهی بیشینهی مقیاس را میدهد.
- ضریب همبستگیCoherency Coefficient (β)
- هزینهی اینکه هر ایجنت باید بداند بقیه چه کردهاند؛ با مربع تعداد ایجنتها رشد میکند.
- مالیات قابلیت اطمینانReliability Tax
- افت ضربی موفقیت در یک زنجیره؛ با نرخ p در هر گام و N گام برابر p به توان N.
- pass^k
- احتمال اینکه ایجنت همان وظیفه را در k اجرای مستقل، هر بار درست انجام دهد.
- زوال زمینهContext Rot
- افت کیفیت پاسخ مدل با افزایش طول ورودی، حتی پیش از رسیدن به سقف اسمی پنجره.
- فشردهسازی زمینهContext Compression
- خلاصهکردن تصمیمها و رویدادهای کلیدی، بهعنوان جایگزین شکستن کار به چند ایجنت.
- زیرایجنت فقطخوانندهRead-only Subagent
- ایجنتی که فقط اطلاعات جمع میکند و یافتهی فشرده برمیگرداند، بدون آنکه در خروجی نهایی بنویسد.
- ارکستریتور-کارگرOrchestrator-Worker
- معماریای که در آن یک ایجنت سرپرست مسئله را میشکند، به کارگرهای موازی میسپارد و نتایج را ترکیب میکند.
منابع
اعداد این مقاله از مقالات داوریشده، انتشارات رسمی سازمانهای سازنده، یا مراجع استاندارد مهندسی عملکرد گرفته شدهاند. محاسبات جدولها بر پایهی همان فرمولهای ذکرشده انجام شده و در متن قابل بازتولیدند.
- Amdahl's Law — سقف شتاب موازیسازی.
- How to Quantify Scalability — The Universal Scalability Law — فرمول USL و نقطهی بیشینه.
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains — تعریف pass^k و افت GPT-4o در بخش خردهفروشی از ۶۱٫۲٪ به کمتر از ۲۵٪.
- Context Rot: How Increasing Input Tokens Impacts LLM Performance — بررسی ۱۸ مدل.
- How we built our multi-agent research system — ۹۰٫۲٪، ~۱۵× توکن، مرزهای کاربرد.
- Multi-Agents: What’s Actually Working — زیرایجنتهای فقطخواندنی، زمینهی تمیز و نوشتن نهایی تکرشتهای.
- Why Do Multi-Agent LLM Systems Fail? — ۱۴ مود شکست، نرخ شکست ۴۱ تا ۸۶٫۷٪.
- Rethinking the Bounds of LLM Reasoning: Are Multi-Agent Discussions the Key? — ایجنت تکی با پرامپت قوی.
- Voting or Consensus? Decision-Making in Multi-Agent Discussions — رأیگیری برای استدلال و اجماع برای وظایف دانشی.
- Multi-LLM-Agents Debate — Performance, Efficiency and Scaling Challenges — بررسی روی ۹ محک.
- پیشبینی حضور ایجنتهای وظیفهمحور در اپلیکیشنهای سازمانی و پیشبینی لغو بیش از ۴۰٪ پروژههای ایجنتیک تا پایان ۲۰۲۷ — هزینه، ارزش نامشخص و کنترل ریسک.
- A2A Protocol Surpasses 150 Organizations — بلوغ پروتکل ارتباط ایجنتها.
- Model Context Protocol — استاندارد اتصال ایجنت به ابزار و داده.